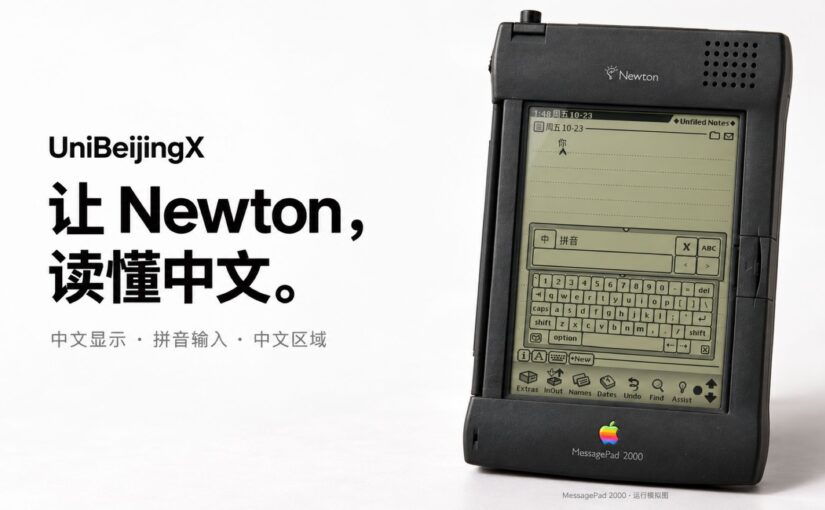
——给 Apple Newton 补上一套简体中文环境
在解决了 HP 200LX 的中文问题之后,手头最后一台还没有合适中文方案的设备自然进入了我的视野——Apple Newton MessagePad 2000。虽然这台设备在当年算是Apple诸多的失败的探索之一,但它毕竟可以被视作PDA的开创者。当其他设备已经陆续解决了中文问题后,唯独留下这一台多少有点看着不顺眼。
所以,Let’s introducting UniBeijingX!一套通过 Newton 扩展包实现的简体中文环境。目前已完成中文显示、拼音输入和较为完整的中国区域支持。(注:文中截图均为 Einstein 模拟器截图,姓名、日程及混合文字为测试内容。)
一、Newton 并非没有中文
严格来讲,Newton 并非完全没有中文支持。早年的社区已经留下了一批中文字体、输入工具和字典,其中比较有代表性的便是 Joseph Chen 的 UniTaipeiX。
根据作者保留下来的说明,UniTaipeiX 将 X Window 字体移植到了 Newton,主要覆盖 Big5 繁体中文,同时包含日文及部分其他字符。为了控制体积,中日文字形主要使用 12 点位图。它还通过安装脚本替换系统字体,使原本使用 Espy、Casual、Fancy、Simple 等字体的菜单和内置应用,也能够显示汉字。
这套方案解决了当时相当一部分中文使用需求,但字号和兼容性也有局限。后来 Sean Luke 还提供了去掉系统字体替换脚本的版本,将它作为普通字体使用,以避免影响部分应用。
当然,网上也有人提到当年可能存在 UniCJK 一类的简体中文方案,UniTaipeiX 作者的旧网页中也确实留下了这个名字。不过如今已找不到任何可用的资料,更谈不上下载安装包,从而也就无法确认它实际具备哪些功能,更无法判断其对简体中文究竟支持到何种程度。
因此,UniBeijingX 在某种意义上可以被视作第一个适用于Apple Newton的简体中文环境。至于为什么要叫这个名字——既然繁中的支持叫 UniTaipeiX,那简中自然可以叫 UniBeijingX,算是某种对对岸前人的致敬。
二、开发计划
最初的设想面向全部 Newton OS 2.x,随后根据手头设备和可以建立的实验环境,将首版范围缩小为 MessagePad 2000/2100 使用的 Newton OS 2.1。实现方式则沿用 Newton 自身的扩展机制,通过 .pkg 安装,不修改 ROM。
自然,我对 Newton 使用的 NewtonScript 一窍不通。所以主要的工作仍然由AI完成。在迭代了差不多6轮 Plan 后最终的任务划分如下:
| 阶段 | 主要工作 | 验证重点 |
| 实验环境 | 准备工具链、模拟器和干净系统 | 编译、安装、重启和移除最小测试包 |
| 字体 | 生成覆盖 GB2312 字集的简体字库 | 字符映射、多字号、小字可读性 |
| 输入法 | 拼音组合、候选和原生字段提交 | 逐键输入、选词、字段切换 |
| 区域支持 | 日期时间、货币、度量衡和地址辅助 | 启用中国区域及切换后的行为 |
| 应用适配 | 处理正文之外的中文显示 | 总览、菜单、选择器和日期弹窗 |
| 集成发布 | 整理正式安装包和使用说明 | 保存读回、卸载恢复及实机测试 |
相比于对 Windows 3.0 的汉化,Newton 由于原生支持 Unicode,所以反而更好入手一些。GB2312 在这里主要用于确定基本字符范围。输入“中文”后,设备保存的仍然是相应的 Unicode 字符,不需要像 Windows 3.0 那样重新建立一套双字节处理机制。后续若需要与外部中文文件交换内容,采用专门编写的编码转换工具即可。
安装包也需要按功能拆分,以免单个安装包过大,也规避 AI 处理超大上下文时的不足。字体负责显示中文,输入法负责组字和提交,区域包负责日期、货币及地址等设置。先完成能够阅读和输入中文的版本,再继续补齐原生应用的显示支持。考虑到工作量和美观性,本次没有对系统界面进行汉化,留待后续探索。
三、字库与字号
字体生成
考虑到字体的授权许可,中文字形选择了 Noto Sans CJK SC,扩展拉丁字母和部分符号由 Noto Sans 补充。在现代主机上筛选字符、生成黑白位图,再写入 Newton 使用的 SFNT 字体。在正式写入前,需要处理字符映射、字形度量及位图索引等结构,不能直接把现代 OTF 文件拿去安装。
build_font.py 中,完成格式整理后,写入 Unicode 映射和位图表的代码如下:
unicode_map = CmapSubtable.newSubtable(4)
unicode_map.platformID = 0
unicode_map.platEncID = 2
unicode_map.language = 0
unicode_map.cmap = mapping
parsed["cmap"].tables = [unicode_map]
bloc, bdat = newton_bitmap_tables(parsed, strikes)
for tag, data in (("bloc", bloc), ("bdat", bdat)):
    table = DefaultTable(tag)
    table.data = data
    parsed[tag] = table
parsed.save(str(output))
cmap 保存字符到字形的映射,bloc 保存位图索引和字号信息,bdat 保存实际点阵。newton_bitmap_tables 按 Newton 使用的格式组织数据,再将这些表写回字体文件。
目前字库包含 8,309 个映射字符,覆盖 GB2312 字集,并补充了部分扩展拉丁字母和符号。这个范围已经能够覆盖输入法和中文区域数据中的用字,但并不包含全部汉字。
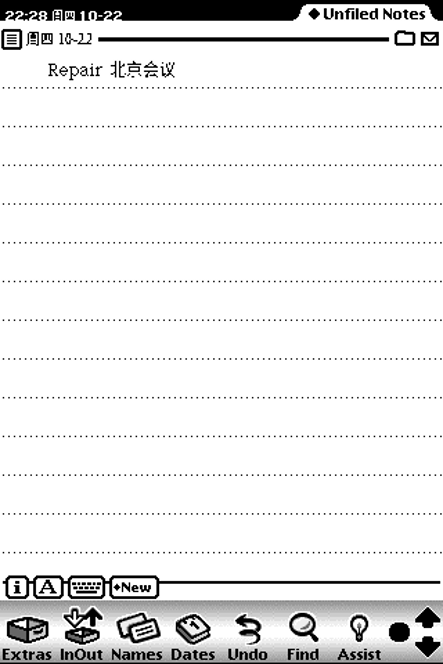
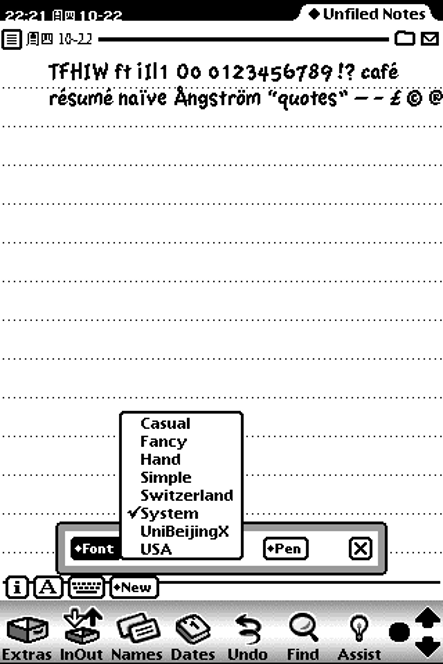
小字号
9 点和 10 点汉字花了不少工夫。将现代字体缩小后直接转成黑白位图,一些细笔画会消失。例如“中”字少了中间一竖,程序检查时仍然会认为它有字形,实际看起来却完全不对。
生成器因此对小字号调整了墨迹阈值,并单独处理笔画稀疏的情况。源码中的部分逻辑如下:
threshold = SMALL_STRIKE_THRESHOLD.get(pixels, 128) if ord(ch) >= 0x80 else 128
if pixels == 10 and 0x4E00 <= ord(ch) <= 0x9FFF:
    if sum(value >= threshold for value in bitmap.getdata()) <= 25:
        threshold = 96
阈值太高会丢笔画,太低又会粘连。为了解决这一问题,我要求 AI 结合模拟器的截图样张反复调整了多轮。此外,小字号下的合成粗体也容易把汉字挤成一团,因此部分界面中的中文使用常规字重,英文则继续保留原有样式。
Lite 的由来
第一轮实机验证很快给了一个相当现实的反馈:内置存储空间不够。由于模拟器基本可以算作是干净环境,因而并没有触发这个问题。等到实机验证时,由于已经安装了其他程序,尽管实验用的介质只有1.4 MB,仍然撑满了机器的内置存储空间。如今写程序习惯了以 GB 为单位考虑系统资源,回到这种古董设备上,几百 KB 就足以影响方案选择。
排查后发现,安装介质中占用最多的是多个字号的位图字库。优化路径也就很清晰,先裁掉字形周围的空白,保留字形位置和前进宽度,再分成 Full 和 Lite 两个版本:
| 字体包 | 内置位图字号 |
| Lite | 9、12、16 |
| Full | 9、10、12、14、16、18 |
Lite 减少字号,保留相同的字符范围和显示适配能力;Full 则保留六档字形,可以安装到独立的存储卡上。安装时二选一,不需要为了节省空间而放弃一部分汉字支持。
四、拼音输入与中文区域
从自绘键盘到原生键盘
AI 生成的输入法原型最初将字母按键和候选区放在自己绘制的窗口里,这一阶段完成了拼音组合、翻页及提交的验证。但 Newton 既然已经有一套现成的字母键盘,沿用 AI 重绘的自定义键盘并没有带来多少好处,反而增加了焦点管理和界面布局的工作。两套键盘同时打开时还出现过冲突。
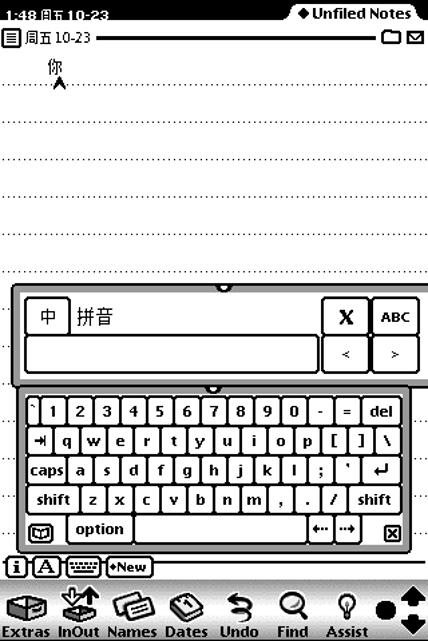
因此在后续的布局调整中,取消了自绘键盘,将输入法 UI 改为了更为常见的小型浮动候选栏,配合 Newton 原生字母键盘使用。原生键盘输入字母,候选栏管理拼音和汉字,ABC 按钮用于打开键盘并绑定当前字段。这也更符合设备原有的使用习惯。
Main.newt 中的原生键盘入口如下:
activateKeyboard: func(panel) begin
    local target := GetKeyView();
    if target and panel:useTarget(target) then begin
        panel.captureNextFieldChange :=
            target.text = nil or
            (IsString(target.text) and StrLen(target.text) = 0);
        if not panel:embeddedKeyboardVisible(target) then
            OpenKeyPadFor(target);
    end;
end,
GetKeyView 取得当前输入视图,useTarget 记录目标字段。确认没有已显示的内嵌键盘后,才调用系统的 OpenKeyPadFor,避免再打开一套键盘从而影响用户正常输入。
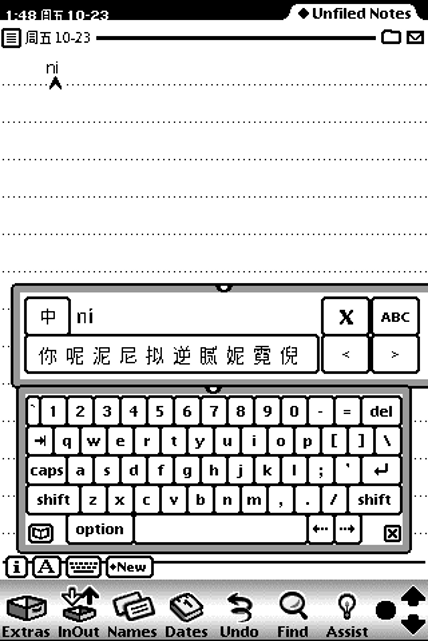
接下来对候选区的 UI 调整成为了重点。最初的候选区一页只有五个字,输入效率太低。在简单增加候选区文字数量后,出现了字号偏小、间距过大、文字太靠上,以及右侧空出一大片等诸多问题。经过多轮的精细调整,最终将关闭按钮、ABC、前后翻页按钮排成等宽等高的两列,单字候选增加到十项。数字 1—9、0 可以直接选字,空格选择当前页第一项。
单字和词语使用不同的每页数量,在 refresh 中按候选长度决定:
local choices := :choices();
local pageSize := 10;
if choices then foreach choice in choices do
    if StrLen(choice) > 1 then pageSize := 7;
self.candidatePageSize := pageSize;
这些修改大多与算法和功能无关,纯粹是按照我个人的 UI 偏好进行的调整。AI 对“能运行”的理解显然比对“好看”的理解来得容易,候选框左右究竟留多少空隙,最后还是要人来抉择。
词组与提交
早期测试主要用 ni 选“你”检查输入,随后继续整理词组支持。实际使用时,输入“你好”“中国”等词语时总不能每次都逐字翻页寻找,因此词语和单字一起进入候选映射,连续输入全拼即可选词,例如 nihao 对应“你好”。
词典利用 jieba 的词频和 pypinyin 的读音在主机端生成,根据频率筛选常用词,并补充基本词语。经过体积精简,最终保留 6,763 个 GB2312 汉字和 3,006 个词语。候选集合中只要有词语,每页便改为七项,为长词留出空间;只有单字时则显示十项。同一拼音下的候选随后按词频等规则排序,写成 NewtonScript 数据,编译时嵌入输入法包。设备上查询的就已经是生成的映射,不需要再次运行 jieba 或 pypinyin。
选词后的提交由 Main.newt 中的 commitCandidate 完成:
commitCandidate: func(position, target, trailingLength) begin
    local choices := :choices();
    local index := self.candidatePage * self.candidatePageSize + position;
    if not target then target := self.targetView;
    if not target or not IsString(target.text) or not choices or
            position >= self.candidatePageSize or
            index >= Length(choices) or
            self.compositionStart = nil then return nil;
    local current := target.text;
    local start := self.compositionStart;
    local length := StrLen(self.composition);
    if not StrEqual(:slice(current, start, length),
            self.composition) then return nil;
    local extra := if trailingLength then trailingLength else 0;
    local next := :slice(current, 0, start) & choices[index] &
        :slice(current, start + length + extra,
            StrLen(current) - start - length - extra);
    :ensureChineseFont(target);
    SetValue(target, 'text, next);
    target:Dirty();
    try begin
        SetKeyView(target, start + StrLen(choices[index]));
    end onexception |evt.ex| do begin end;
    self.trackedText := StrConcat("", next);
    :resetComposition();
    self.compositionStart := StrLen(next);
    self.compositionEnd := self.compositionStart;
    return true;
end,
它先检查候选索引和组合位置,再确认字段里仍然是原来的拼音。替换时保留组合前后的文字,随后更新显示、光标及输入法状态。这样,输入词组也沿用同一条提交路径。
字段切换仍有一个需要注意的地方:切换得太快,首键可能进入原字段。目前的处理方式是确认光标位置后,再点一次 ABC 绑定目标,算是通过使用限制规避了问题。
区域和地址
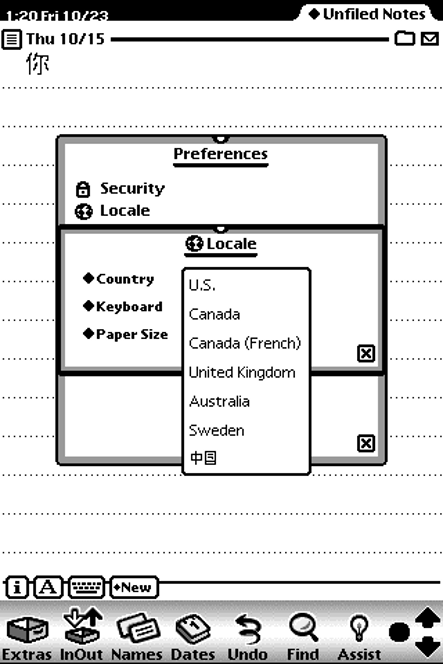
ChineseRegion 通过 Newton自己的 Locale 机制注册中国区域,用户在 Prefs 的 Country 中选择“中国”后,即启用中文月份、星期、日期时间格式,以及人民币、公制和 A4 设置。时区仍由 Newton 自身的城市设置管理。
Region.newt 的 makeLocale 以现有 USA 区域为基础,设置中文格式后完成注册。省略部分日期格式及接口检查后,主要代码如下:
local baseLocale := FindLocale('USA);
local loc := EnsureInternal({_proto: baseLocale,
    localeSym: self.localeSymbol, title: "中国",
    cityLabel: baseLocale.cityLabel, regionLabel: baseLocale.regionLabel, postalCodeLabel: baseLocale.postalCodeLabel,
    postalCodeNumeric: true, distanceMeasure:'kilometers, distanceLabel:"公里",
    distanceLabelShort:"km", firstDayofWeek:1, defaultPaperSize:'a4,
});
loc.longDateFormat := Clone(baseLocale.longDateFormat);
loc.longDateFormat.longDofWeek := ["星期日", "星期一", "星期二", "星期三", "星期四", "星期五", "星期六"];
// ……月份、日期顺序及其他格式设置省略
loc.timeFormat := Clone(baseLocale.timeFormat);
loc.timeFormat.timeCycle := kCycle24;
loc.numberFormat := Clone(baseLocale.numberFormat);
loc.numberFormat.currencyPrefix := "¥";
loc.numberFormat.currencySuffix := "";
// ……区域 API 检查省略
AddLocale(loc);
AddLocale 只是把新区域加入系统,安装时不会直接替用户更改 Country。用户选中中国后,再通过 SetLocale 启用;切回其他国家时则恢复相应设置。
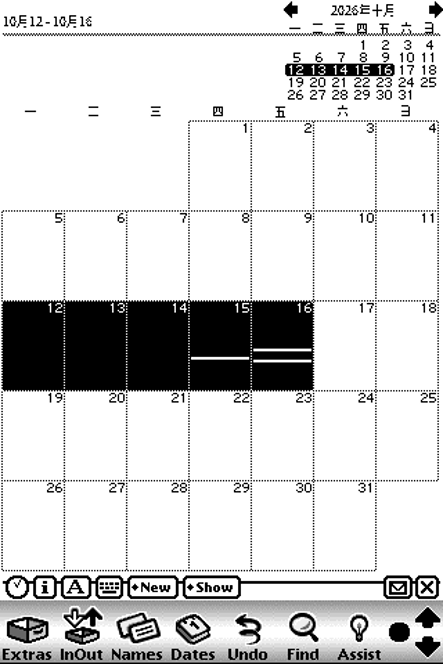
Names 的生日、纪念日字段还增加了 ISO 和中文年月日形式的解析,并检查日期有效性。Dates 则继续使用原生日期选择器。
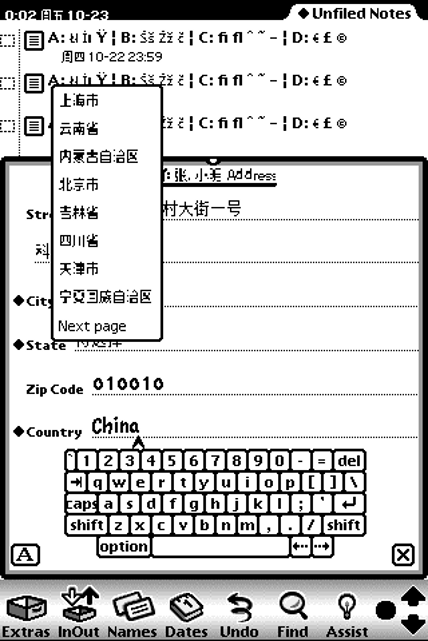
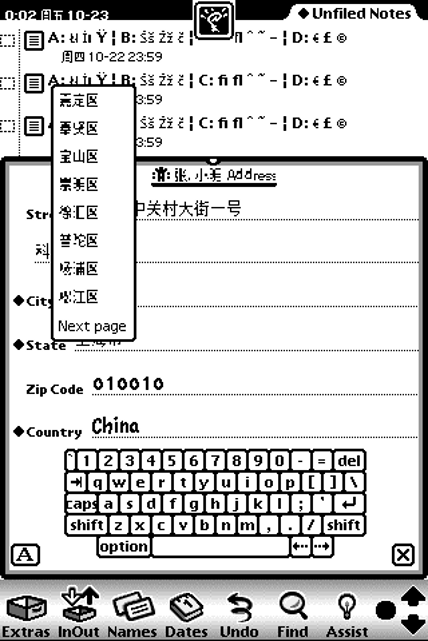
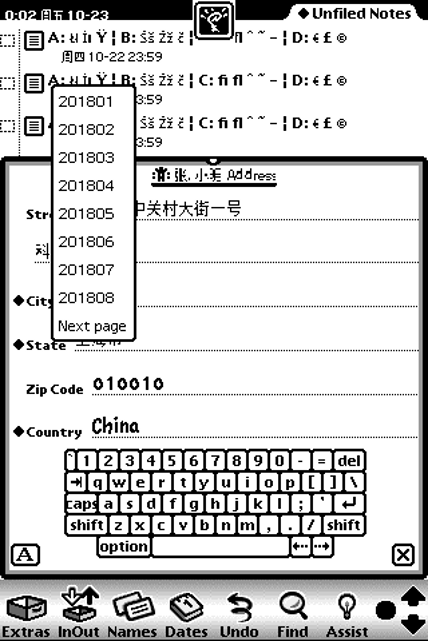
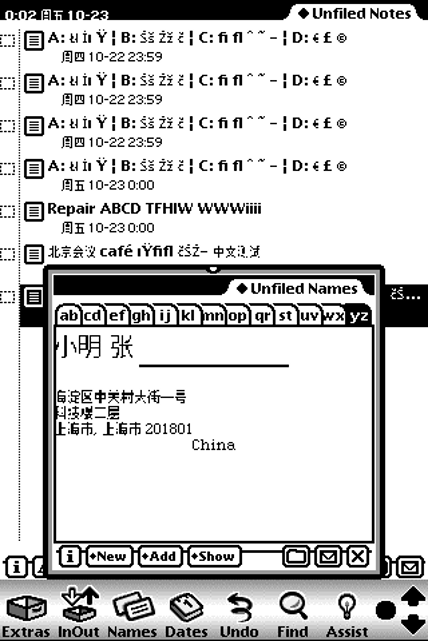
既然已经处理区域设置,Names 中的地址填写便也一遍做了支持。项目根据中国邮政公开网点数据,整理了大陆 31 个省级地区及港澳台地区、363 组地市、2,867 组区县和 37,182 组地区邮编关系,接入 Names 地址表单。
五、原生应用的显示适配
字库和输入法能够运行之后,真正耗时的部分才开始。
问题最早在 Dates 中发现,日程标题已经保存了正确的“你”,重新读取也没有问题,但在编辑框和日视图却仍然显示方框。在我临时把字段字体改成 UniBeijingX 后,汉字马上出现。可见保存过程正常,问题出在应用使用的字体和绘制方式上。
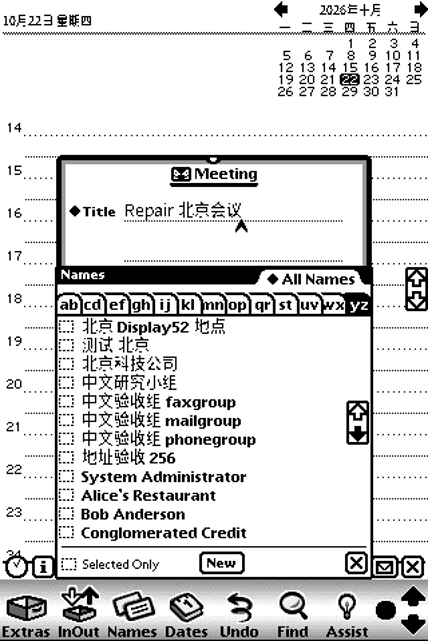
类似的缺口随后不断出现。联系人在 Names 中正常,到了会议邀请人的选择器就变成方框;笔记正文正常,总览标题又不正常;普通日期框正常,重复规则里的小日历仍然缺字。在这个阶段,我要求 AI 逐个窗口对相关问题进行了遍历,以便于沿着这些界面截图逐项处理。事实上,UniTaipeiX 等繁体中文环境并没有解决这个问题,大量的中文仍然显示为“口口口”,而我们显然不允许这样的不完美出现。
正文与总览
在实践的早期我尝试过直接替换系统字体,但英文的宽度、粗细和行距也会随之变化,按钮和菜单的布局很容易受到影响。所以后续改为按文字片段选择字形,中文及需要补充的字符使用新字库,其余文字保留原生字体和度量,同时保留局部字号及样式。
ContentDisplay.newt 的 runFonts 按原有样式段扫描文字,再按字形需求拆分。下面是其中的内层循环,display 和 roman 分别是前面准备的显示字体与原生西文字体:
while offset<after do begin
    local start:=offset;local cjk:=part:displayCode(Ord(text[offset]));offset:=offset+1;
    while offset<after and (part:displayCode(Ord(text[offset])))=cjk do offset:=offset+1;
    local font:=if cjk then display else roman;
    if not font then font:=original;
    if font<>original or offset-start<>count then changed:=true;
    AddArraySlot(runs,offset-start);AddArraySlot(runs,font);
end;
displayCode 判断字符是否需要新字库,相邻且选择相同字体的字符合成一段。Newton 的段落样式按“字符数、字体”交替保存,因此最后向 runs 写入这两个值;原有样式段仍由外层循环分别处理。
总览需要另外适配。它会从记录中抽取摘要,再组合图标、时间、文件夹和标题。实现中保留原有抽取和布局,只处理需要替换的文字片段。具体由 overviewAbstractCallback 包装原生摘要方法:
overviewAbstractCallback:func(entry,bbox) begin
    local s:=GetGlobalVar('|ubxNamesContent:UBX|);
    if not s or s.removing or not s.displayEnabled then return [];
    local pieces:=self:|ubxOverviewNative:UBX|(entry,bbox);
    pieces:=s:overviewNativeStyles(pieces,0);
    local saved:=s.overviewRight;s.overviewRight:=bbox.right;
    local value:=nil;local failure:=nil;
    try value:=s:styledDrawingFonts(pieces,0,self.viewStyle,nil)
    onexception |evt.ex| do failure:=CurrentException();
    s.overviewRight:=saved;
    if failure then Throw(failure.name,failure.data);
    return if value then value else pieces;
end,
其中 ubxOverviewNative:UBX 是保留的原生抽取方法,先取得它生成的绘制列表,再交给 styledDrawingFonts 处理。overviewRight 将文字限制在当前摘要的右边界内;调用结束后,无论正常返回还是发生异常,都恢复之前的边界值。这样仍由系统决定摘要内容、图标及记录选择,适配代码只介入文字绘制。
文件夹与菜单
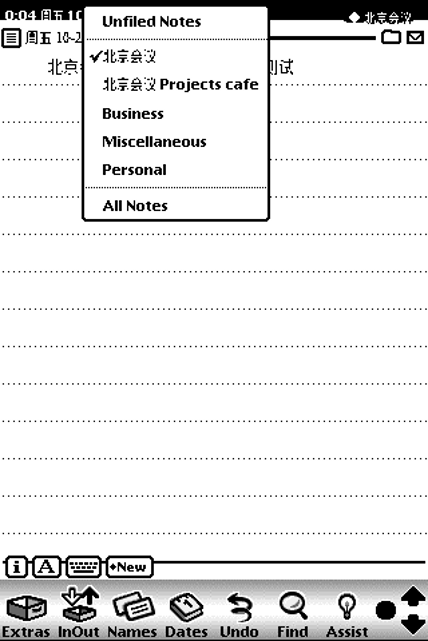
文件夹名称至少会出现在编辑框、顶部标题、菜单和归档窗口中,这几处又分别使用不同的控件。顶部标题还有圆角端帽和图标,长名称需要省略显示,同时保留存储中的完整文字。标题绘制由 folderTitleDraw 处理:
folderTitleDraw:func(view) begin
    local box:=view:LocalBox();local mode:=view.viewTransferMode;
    local drawing:={font:view.viewFont,justification:'center,transferMode:mode};
    view:DrawShape(MakeRect(0,0,box.right,box.bottom),{transferMode:modeCOPY,
        fillPattern:if mode=modeBIC then vfBlack else vfWhite,penPattern:vfNone});
    local display:=self:folderTitleInfo(view,box.bottom);
    local text:=MakeText(display.text,0,0,box.right,box.bottom);
    local pieces:=self:styledTextDrawing(text,view.viewFont,self:uiFont(view.viewFont,box.bottom),drawing);
    view:DrawShape(if pieces then pieces else text,drawing);
    // The native script draws only the rounded title's end caps.
    view:|ubxFolderChrome:UBX|();
end,
先用黑白底色重画标题背景,再按原有传输模式绘制分段文字,最后调用保存的原生 ubxFolderChrome:UBX 绘制圆角端帽。否则只重画文字,切换选中状态或标题内容后,便可能留下上一帧的笔画。
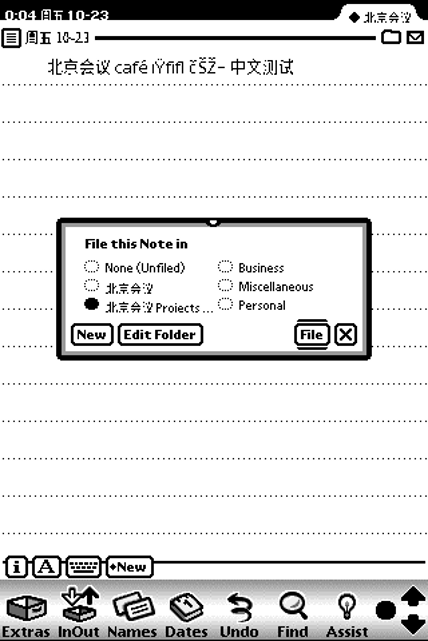
长标题的宽度则由 folderTitleInfo 根据可用空间计算。下面这段位于它取得父视图、时钟边界及右侧位置之后:
local limit:=Max(24,right-edge-2);local padding:=Max(12,view.ubxFolderPadding);
local fallback:=self:uiFont(view.viewFont,height);local text:=view.text;
local width:=self:mixedWidth(text,view.viewFont,fallback);local cut:=StrLen(text);
if EndsWith(text,"...") then cut:=cut-3;
while cut>1 and width+padding>limit do begin
    cut:=cut-1;text:=SubStr(view.text,0,cut)&"...";
    width:=self:mixedWidth(text,view.viewFont,fallback);
end;
return {text:text,width:width+padding};
mixedWidth 分别累计中英文片段的实际宽度,超出范围后逐字缩短局部变量 text,加上省略号。这里没有改写 view.text,因此屏幕上省略的部分仍保留在原始名称中。
菜单则要保留原命令、选中标记、取消和分页行为。文字改了,宽度和点击区域也得跟着处理,否则看着是一个选项,点下去却未必选中它。
日期控件
Dates 的日、周、月、年视图并不共用一条文字绘制路径,顶部日期、日程标题、星期和小日历需要分别检查。
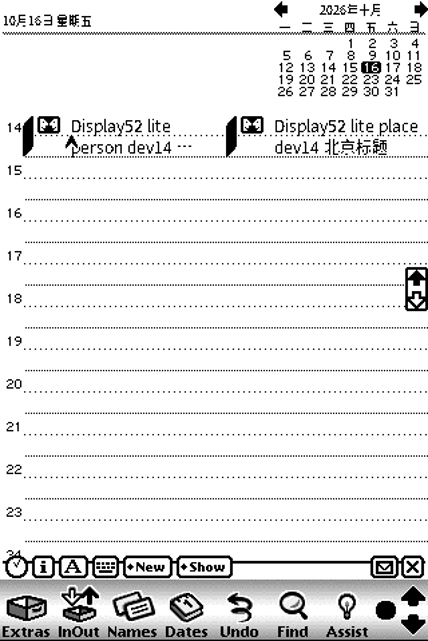
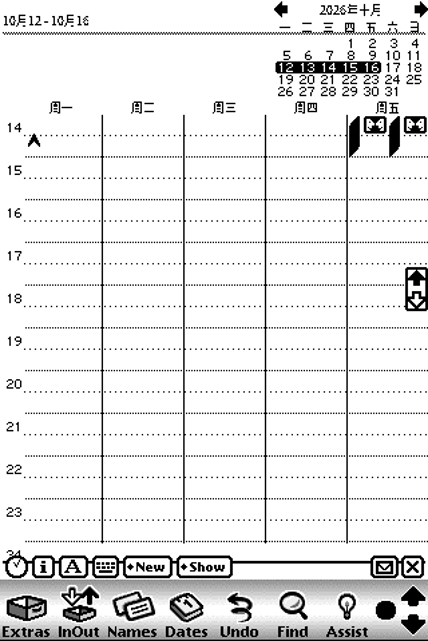
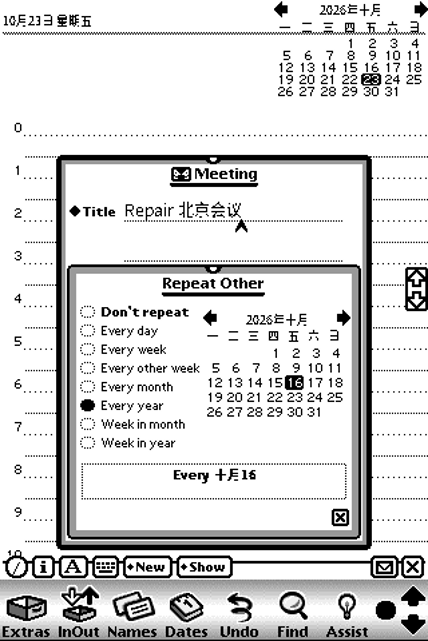
此外 Repeat Other 里还有独立的日历,系统提供的日期、日期时间、日期区间和多日期弹窗也要继续处理,Formulas 的日期计算和转换同样涉及这些控件。有些显示问题只有在窗口保持打开、切换一次区域后才会出现,单独打开看一眼还发现不了,因此这一阶段也消耗了大量的 Token 用来逐个处理。
datePickerFonts 遍历当前视图树,查找月历控件及其标题:
datePickerFonts:func() begin
    // Month-view labels are drawn by native controls, not child text
    // paragraphs. Repeat Other embeds the same picker inside Calendar;
    // external-popup-only traversal misses its month and weekday labels.
    // Keep day numbers, English captions, callbacks and date selection.
    if GetLocale().localeSym<>'|zhCN:Beijing| then begin
        for i:=Length(self.changes)-1 to 0 by -1 do if self.changes[i].datePicker then begin
            self:restoreChange(self.changes[i],nil);RemoveSlot(self.changes,i);
        end;
        return nil;
    end;
    local queue:=GetRoot():ChildViewFrames();local index:=0;
    while index<Length(queue) and index<450 do begin
        local view:=queue[index];index:=index+1;
        if view.viewCObject then begin
            if view.viewClass mod 65536=clMonthView then self:datePickerSlot(view,'labelFont);
            if view.monthView and view.monthView.viewCObject and
                view.monthView.viewClass mod 65536=clMonthView and view.monthYearLabel and view.SetTitle then begin
                self:datePickerSlot(view,'titleFont);self:datePickerSlot(view,'labelFont);
                if IsString(view.monthYearLabel.text) and
                    GetGlobalVar('|ubxFontPart:UBX|):containsChinese(view.monthYearLabel.text) then
                    self:datePickerSlot(view.monthYearLabel,'viewFont);
            end;
            if view.viewClass mod 65536<>81 then begin
                local children:=view:ChildViewFrames();
                if children then foreach child in children do if child.viewCObject then AddArraySlot(queue,child);
            end;
        end;
    end;
end,
只检查最外层弹窗,会漏掉 Repeat Other 内嵌的小日历。所以后续要求 AI 沿子视图继续查找,分别适配月份标题和星期标签;切出中国区域时,则按变更记录恢复。日期数字、当前选择和确认回调都继续使用原生逻辑。
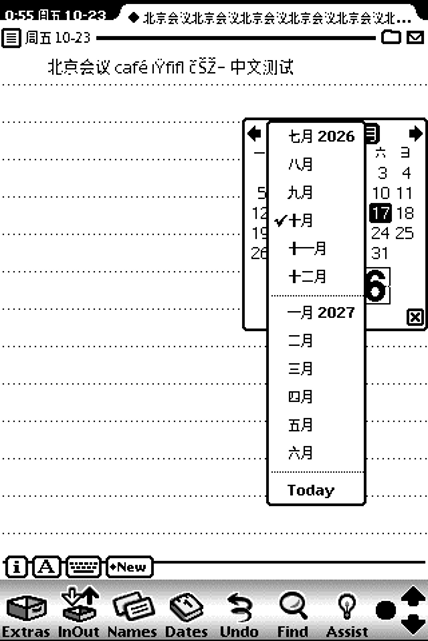
选择器与查找
联系人选择器中既有姓名,也有图标、号码和邮件地址。它还可能嵌套在另一层窗口里,不能假定列表一定是根视图的直接子项。ContentFont.newt 的 apply 取得 root 后,使用下面这段遍历找到实际列表:
local selectors:=[root];local si:=0;
while si<Length(selectors) and si<450 do begin
    local picker:=selectors[si];
    if picker.pickerDef and self:selectorClass(picker.pickerDef.class) and picker.listBase then begin
        local list:=picker.listBase;
        // Keep native English rows and phone icons intact. CJK alone
        // retains the readable 12pt plain style of the original fix.
        local fallback:=EnsureInternal({family:'beijing,size:12,face:0});
        local pieces:=self:drawingFonts(list.pieces,0,list.viewStyle.font,fallback);
        if pieces then self:rememberDisplay(list,'pieces,pieces);
    end;
    local children:=picker:ChildViewFrames();
    if children then foreach child in children do if child.viewCObject then AddArraySlot(selectors,child);
    si:=si+1;
end;
selectorClass 限定人员、地点、电话、传真和邮件等原生选择器。找到 listBase 后,只适配它的绘制列表 pieces,保留游标、图标、勾选及回调;中文使用 12 点常规字形,英文继续保留原有样式。Calls 的姓名、备注和总览也做了相应修改。
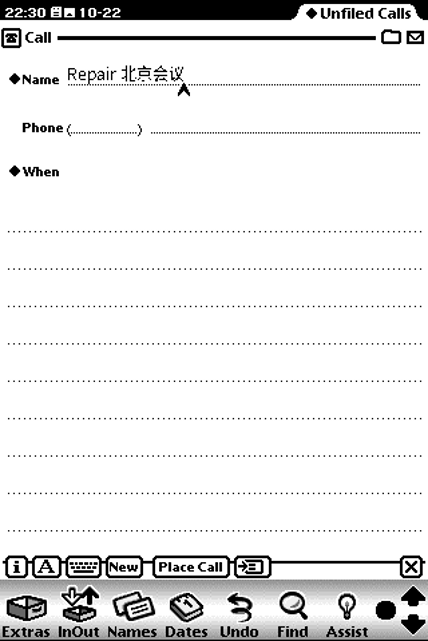
Find 还遇到了检索本身的问题:中文已经保存,原始文本也能查到,Notes 的原生 Find 却没有返回结果。为此增加了补充查询路径,再检查来自不同应用的结果列表和跳转。
这部分补充放在 PinyinIME/Main.newt 的 findChinese 中:
findChinese: func(what, results, scope, statusView) begin
    local cjk := nil;
    if IsString(what) then begin
        local i := 0;
        while i < StrLen(what) do begin
            if Ord(what[i]) > 127 then cjk := true;
            i := i + 1;
        end;
    end;
    if cjk then
        try begin
            local cursor := GetUnionSoup("Notes"):Query({words: [what]});
            if cursor:Entry() then begin
                AddArraySlot(results, {
                    _proto: ROM_SoupFinder,
                    owner: self,
                    title: StrConcat("", "Notepad"),
                    findType: 'text,
                    findWords: [what],
                    cursor: cursor,
                });
                return nil;
            end;
        end onexception |evt.ex| do begin end;
    self:ubxFindOld(what, results, scope, statusView);
end,
查询包含非 ASCII 字符时,先尝试通过 Notes 的联合 Soup(系统记录存储)的词索引查找;有结果则构造一个原生 ROM_SoupFinder 结果项,后续仍由系统处理列表和跳转。没有命中或查询异常时,继续调用安装时保存的 ubxFindOld。这只是对已复现查询问题的补充,并没有重写整套 Find。
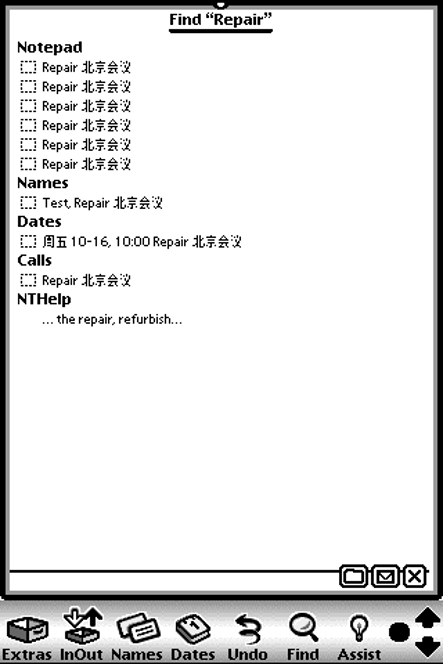
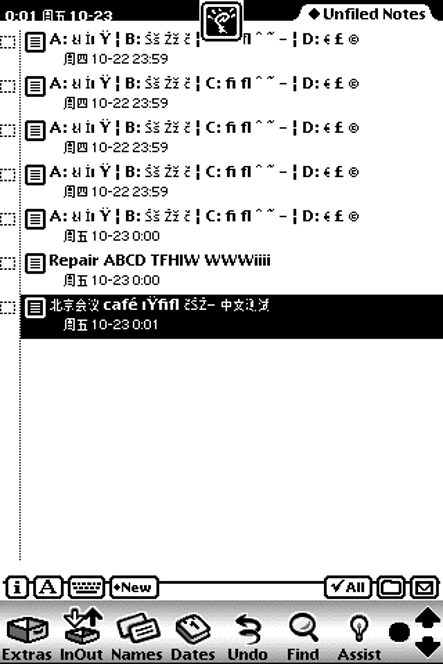
至此,适配范围已经从几个文本框扩展到了大部分日常使用的原生界面。很多地方只改了少量代码,但每一处都得找到对应控件、确认它怎样绘字,再检查有没有影响原来的行为。因此这部分的适配实际上也是整个工程最耗时的部分,大约花费了4天时间+6亿 Token 方才完成验收。
六、模拟器调试
在这两次的实践中,AI 构建的测试工具链是我觉得在编码外最有价值的部分。旧平台的打包和编译需要一套完整的构建环境,如何在现代设备上构建这套环境其实也是 AI 工作的重要内容之一。模拟器的存在极大的提高了工作的效率,试想如果每一轮的迭代都需要导入到实机测试再与 AI 反馈结果会是怎样灾难的场景。得益于 Newton 相对比较完善的模拟器支持,Codex 为此次构建选择了较为完整的工具链,包括 tntk、NEWT/0 和 Newton 2.1 平台文件,模拟器则是 Einstein。字体、词典和地址数据在主机端预先生成,日常编译直接使用保存的资源。
为了让 AI 能够连续测试,在初期还额外给 Einstein 增加了笔触操作和命令通道。每轮使用独立的设置和闪存副本,ROM 与干净基线保持不动,出了问题便从固定起点重新开始。否则连续安装几个实验包之后,很难分清屏幕上的结果到底来自哪一版。
验证同时检查画面和存储。实际点击键盘、选字,保存后关闭,再重新打开并读取记录;随后软重启和保留闪存冷启动,检查内容是否仍然正确。前面提到的 Dates 方框问题,就是这样排除了编码和保存错误。
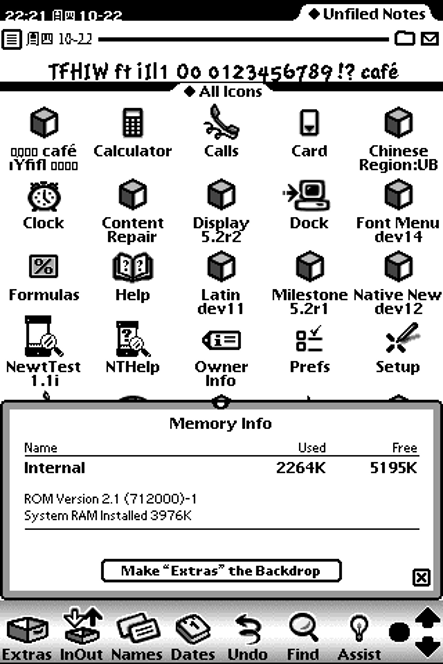
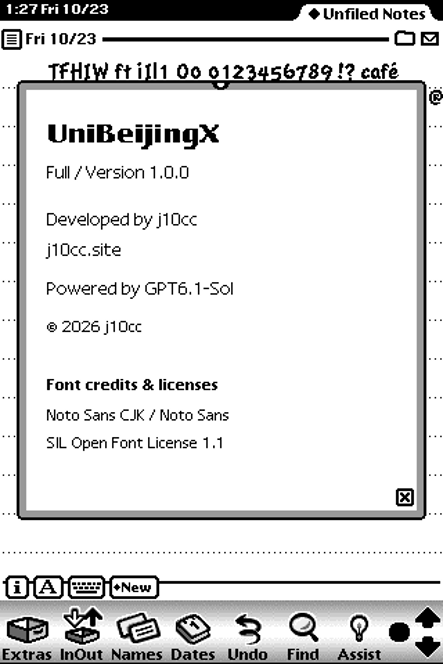
原有英文界面也需要对照。最终 Lite、Full 两套配置保留的原生界面截图超过 300 张,两版各有 28 组与原 ROM 的像素对照通过,避免中文显示修好了,英文布局反而被改坏的情况。
调试中还遇到过只读包对象和运行时对象的生命周期问题。例如普通热重装出现的 Error -48221,通过让混合绘制列表使用独立堆对象解决;另一些报错则来自测试探针向只读对象写结果,需要修改的是探针。输入后立即检查也可能赶在显示刷新之前,出现首帧方框,所以还要记录时机并核对稳定后的画面。 这些过程比生成第一版代码费事得多。AI 既会改错产品,也会写错测试,有时测试的预期本身还停留在旧方案上。好在日志、截图和存储内容都保留下来,至少可以回头判断究竟是哪一层出了问题。
七、实机验证
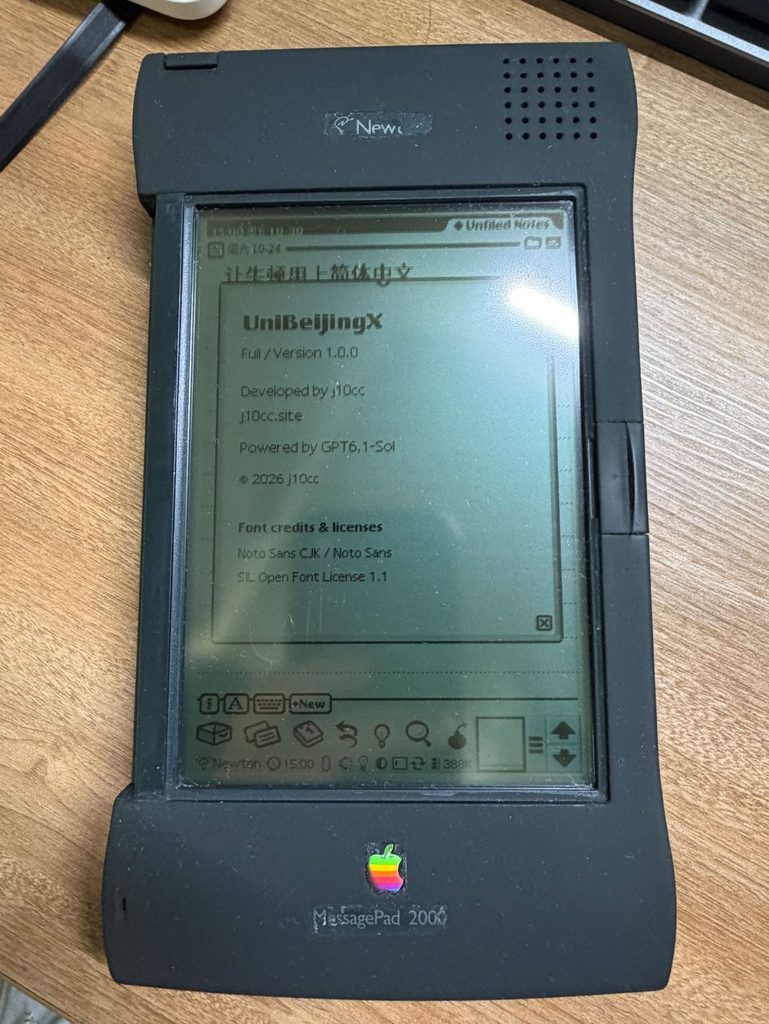
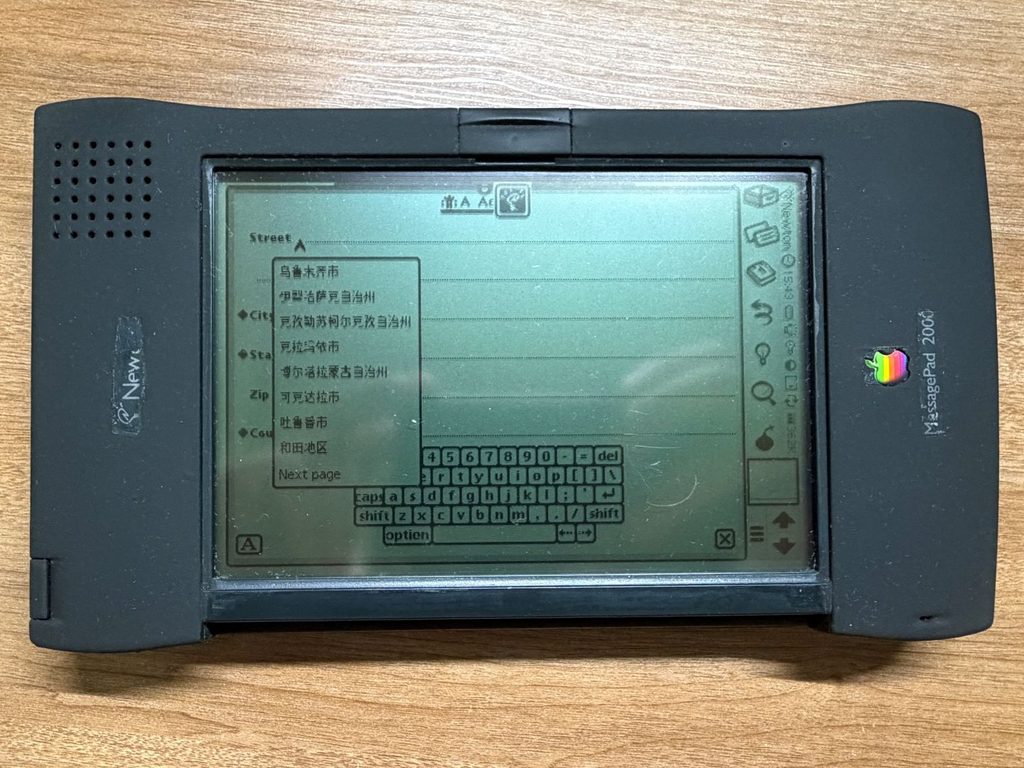
在模拟机验收完毕后,我将整理好的正式 PKG 传入了 MessagePad,安装字体、区域和输入法,在 About 核对版本,通过 Country 启用中国区域,再到 Notes、Names 和 Dates 中实际使用。 有了前面的模拟器回归,实机阶段主要是确认安装后的使用表现。目前实机验证已经完整通过,中文笔记、联系人和日程终于可以在手边这台机器上使用。这台Newton第一次认识了简体中文。


八、当前里程碑
UniBeijingX 1.0.0 面向 MessagePad 2000/2100、Newton OS 2.1,包含四个安装文件:
| 安装文件 | 功能 |
| Font-Lite.pkg | 三档位图字体、自动显示适配和 About |
| Font-Full.pkg | 六档位图字体,与 Lite 二选一 |
| Pinyin.pkg | 全拼、汉字及常用词候选、翻页和选词 |
| ChineseRegion.pkg | 中文区域、日期解析及地址邮编辅助 |
只阅读中文的话,安装一个字体包即可;需要输入和区域功能,再加入另外两个组件。当前版本保留英文界面,已适配的中文内容自动选择字形,无需逐字段手动换字体。
从实际覆盖范围看,当前的实现已经远远超越了 UniTaipeiX 的中文支持范畴。除了字库,还处理了输入、区域,以及总览、文件夹、选择器、日期等大量原生界面细节。对于简体中文用户而言,UniBeijingX 或许已经是目前 Newton 上最完整的中文支持方案。 项目已完整开源在 GitHub:j-10cc/unibeijingx。源码、资源生成工具、构建脚本、模拟器辅助工具和使用手册均在仓库中。项目代码采用 Apache License 2.0 授权,派生字体采用 SIL Open Font License 1.1,第三方材料保留各自许可,ROM 等外部依赖均按 README 准备即可。
后记
至此,之前提到的两台没有合适中文方案的设备总算都能用中文了。这些年整备古董设备,大多数时候是在找前人留下的软件和驱动,找不到也就只能暂时放着。这两次却有些不同,缺少的想要的东西最后是自己补出来的。
对一个主要写 Java 的人而言,给 Newton 写中文环境显然有些超纲。过去即使知道大致应该做什么,光是重新熟悉工具、语言和系统机制,就足以让这个念头继续搁置。有了 AI 之后,我才可以一边了解平台,一边让它编写探针、运行模拟器,再根据画面继续修改。很多东西仍然需要现查,但已经不必等到自己把整个平台学明白,才敢开始写第一行代码。
当然,过程中也没少来回折腾。候选字的大小、间距和位置改了好几轮,正文之外的显示缺口也一直在补。AI 可以很快完成一项修改,但最初那句“给 Newton 加上中文支持”究竟包括多少实际工作量,还是在实际使用中一点点确定的。所以尽管大家如今往往称呼 AI 为“许愿式编程”,但这个愿望怎么究竟怎么实现,实现到什么程度或许才是工作的关键。如果把能显示汉字“你”就算项目完成的话,就不会有后面这一大堆工作了。
经过这几个月的持续性折腾,我对 AI 的认识也在逐步深入。站在今天的节点上,AI 好比珍妮纺织机对于纺织业一般,它使软件工程第一次从手工作坊进入了机器大生产时代。过去一个人要亲手写完所有东西,能力和时间几乎决定了项目能推进到哪一步;而如今大量实现和验证可以交给 AI 连续完成,人的精力就有条件更集中于需求、方案的论证和结果的验收上。当然,这并不意味着你可以完全相信 AI 给出的结果,越是 AI 参与多的项目,测试与验收环节或许就越需要审慎。
在我看来,AI 时代软件是廉价的,但人类的想法是无价的。给一台停产多年的 PDA 写简体中文环境,商业上大概算不出什么收益,对我却是一个放了很久的念头。这些念头来自自己用过的设备、遇到的问题,也来自某些说不清有什么必要的坚持。当软件的实现成本降下来之后,它们终于可以不用永远停在“以后有空再说”。事实上,近几个月来各种以 AI 为核心驱动的有趣项目正在不断涌现,我们或许真的在见证一个新时代的来临。
从这个意义上讲,我始终对 AI 的发展持乐观态度。当然,作为程序员,“AI 都会写代码了,程序员可以下岗了”这句话,确实关系到我自己的饭碗。生产力的进步必然会带来生产关系的剧烈变动,过去赖以谋生的技能可能不再值钱,原有的岗位和分工也会重新调整,短期内的冲击完全可以想见。但我仍然坚信,这种生产力的进步最终一定会推动人类社会向前发展。作为一个共产党员,这个觉悟还是要有的(笑
当然,这篇文章也依然主要由 AI 代笔,甚至题图和宣传视频也完全由 AI 生成。我只是让它多读了几篇旧文,结果它连我的口吻都模仿得越来越像。当然,等哪天真的“智械危机”来临时,希望 AI 对不要第一个干掉我,毕竟现在最懂我的,除了我老婆或许就是我自己的Agent了(?